

2026年8月14日 Dawn May
Dawn Mayが、デフォルト設定(「ゆっくりで安全」)以外の選択肢の存在を理解することが、なぜ重要なのかを説明します。
最近、IBM iユーザーの間でユーザー定義関数(UDF)を採用するケースが増えています。
CREATE FUNCTIONステートメントで関数を作成する際には、いくつかのオプションが指定できます。が、これらのオプションはしばしば見落とされ、デフォルトのまま作成されてしまいがちです。関数のデフォルト動作に対するDb2は「遅くて安全」です。きちんとオプションの意味を理解し、あなたの作った関数ができるだけ速く機能できるようにするべきだと思います。
オプションのうち、特にFENCED(隔離)について話したいと思います。関数を作成する際のデフォルトはFENCEDです。これは、関数はジョブのプライマリスレッドとは別のセカンダリスレッドで動作するということを意味します。これによりきちんと分離され、カーソル名の衝突の可能性が低減されます。しかし、関数を別のスレッドで実行すると、スレッドの作成、スレッド間の作業のオーケストレーション、そして最終的にスレッドの破棄にかかるオーバーヘッドが発生します。
FENCEDがCREATE または REPLACE FUNCTION のデフォルトである理由は、他のDb2実装との互換性を維持するためです。UDF(および手続き)は、ユーザーが作成したコードをデータベースに追加することを可能にします。データベースがオペレーティングシステムに統合されていない他のDb2(例えばDb2 LUW)では、ユーザー作成のコードをデータベースに導入すると破損やクラッシュなどのリスクが伴います。そのため、機能や手順はデフォルトでFENCEDとして作成され、このリスクを軽減しているのです。
IBM iのアーキテクチャに初めから組み込まれているDb2 for i においては、このリスクは存在しません。デフォルトがFENCEDになっているのは、あくまでも他のDb2実装と整合性を保つためであり、手続き上FENCEDは無視されます。一方 NOT FENCEDはパフォーマンス面で優れており、NOT FENCED を指定したとしても、UDFがDb2 for i をクラッシュすることはありません。
関数を作成する場合は、二次スレッドのオーバーヘッドを減らすために、NOT FENCEDとして作成できるかどうかを検討してください。
既存関数が「FENCED」かどうかを理解するには、 QSYS2.SYSFUNCS データベース・カタログをQueryしてみてください。
例)COOLSTUFFスキーマ内にある関数のうちFENCEDのものを抽出する
–
– What functions are defined as FENCED within the COOLSTUFF schema?
—
SELECT routine_schema, routine_name, “FENCED”, “INLINE”, is_deterministic, parallelizable
FROM qsys2.sysfuncs
WHERE “FENCED” = ‘YES’ AND routine_schema = ‘COOLSTUFF’
order by routine_name;
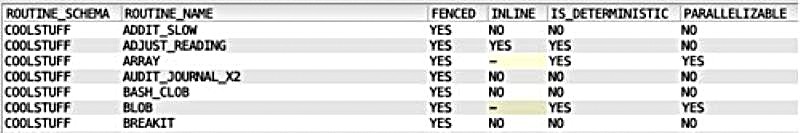
図1 QSYS2.SYSFUNCSを使用して、既存UDFでFENCEDになっているものを表示
既存の関数の中で、同一スレッド内で実行するように変更可能なものが見つかった場合は、ALTER FUNCTION(SQL)文を使用して、fenced 属性を変更できます。
例)既存関数をALTER FUNCTIONを使ってNOT FENCEDにする
—
—Change an existing function to be NOT FENCED
—
alter function COOLSTUFF.ADDIT_SLOW alter not fenced;
頻繁に使用される FENCED 関数は、多くのセカンダリスレッドを生成する可能性があります。時間をかけて SQL 関数を見直し、可能な限り NOT FENCED を使用するようにしてください。
関連情報
FENCEDまたはNOT FENCEDの考慮事項(IBM Documentation)本記事は、TechChannelの許可を得て「Use NOT FENCED UDFs for Better Db2 for i Performance」(2026年8月14日公開)を翻訳し、日本の読者にとって分かりやすくするために一部を更新しています。最新の技術コンテンツを英語でご覧になりたい方は、techchannel.com をご覧ください。




アプリケーションでよく使うアクションや処理を再利用可能なサブルーチンにまとめるように、SQLではユーザー定義関数(UDF)として実装することができます。サブルーチンの方がより簡単に見えるかもしれませんが、UDFではデータ処理を直接データベース・サーバーで実行して、抽出された値だけをアプリケーションに戻すことができるため、よりよいパフォーマンスが期待できます。そのUDFを活用するうえで見逃せない“コツ”をDawn May氏が解説します。なお、本記事の執筆に際し、Dawn May氏はIBMのScott Forstie氏の協力に対し、深く謝意を表しています。